איך בדיוק כלי SEO אוספים נתונים מדפי תוצאות החיפוש של גוגל
אם קיבלתם שלושה מספרים שונים משלושה כלים, כדאי לשאול מאיפה בכלל מגיע המספר הזה. הכלים לא מקבלים אותו מגוגל דרך ממשק פתוח שמציג את כל האתרים ברשת. Google Search Console נותן גישה רק לנתוני האתר המאומת שלכם. אם אתם רוצים להבין איך נראים דפי תוצאות החיפוש של גוגל עבור אתר אחר, או עבור ביטוי בלי בעלות על האתר, צריך לאסוף את המידע מהעמוד הציבורי עצמו.
בפועל, איסוף המידע עובד כך. התוכנה שולחת חיפוש אוטומטי, מנסה להיראות כמו משתמש רגיל מאזור מסוים וטוענת את דף התוצאות. אחר כך היא שולפת מהעמוד את הכותרות, הקישורים, הסניפטים, התוספות שמופיעות מעל התוצאות האורגניות ולעיתים גם את המיקומים עצמם. האיסוף מפרק את מבנה ה-DOM, כלומר קורא את מה שהדפדפן קיבל והציג בפועל.
מפרוטוקול פשוט לדפדפן מלא: מה קורה מאחורי הקלעים
פעם היה אפשר לבצע בקשת HTTP פשוטה ולקבל HTML שאפשר לנתח די בקלות. היום זה הרבה פחות יציב. גוגל בונה חלקים גדולים של המסך בצורה דינמית, בודקת את סביבת ההרצה, ומצפה להתנהגות של דפדפן אמיתי. לכן הרבה מערכות עברו לעבוד עם מנועי JavaScript אמיתיים, או עם דפדפנים חסרי ממשק, שמסוגלים להריץ סקריפטים, לטעון רכיבים דינמיים ולהתמודד עם דפי ביניים.
הפער בין מה שבעלי עסקים מדמיינים לבין מה שכלי המעקב באמת יכולים לספק מתחיל כאן. סריקה רציפה בזמן אמת של המון ביטויים, מכשירים ואזורים היא פעולה כבדה ויקרה, וגוגל חוסמת מהר יותר דפוסים שנראים כמו איסוף אוטומטי מסיבי. לכן רוב הכלים לא שומרים תמונה חיה לכל רגע. הם עובדים עם זיכרון מטמון או עם סבבי איסוף קבועים, לפעמים פעם ביום ולפעמים פעם בשבוע.
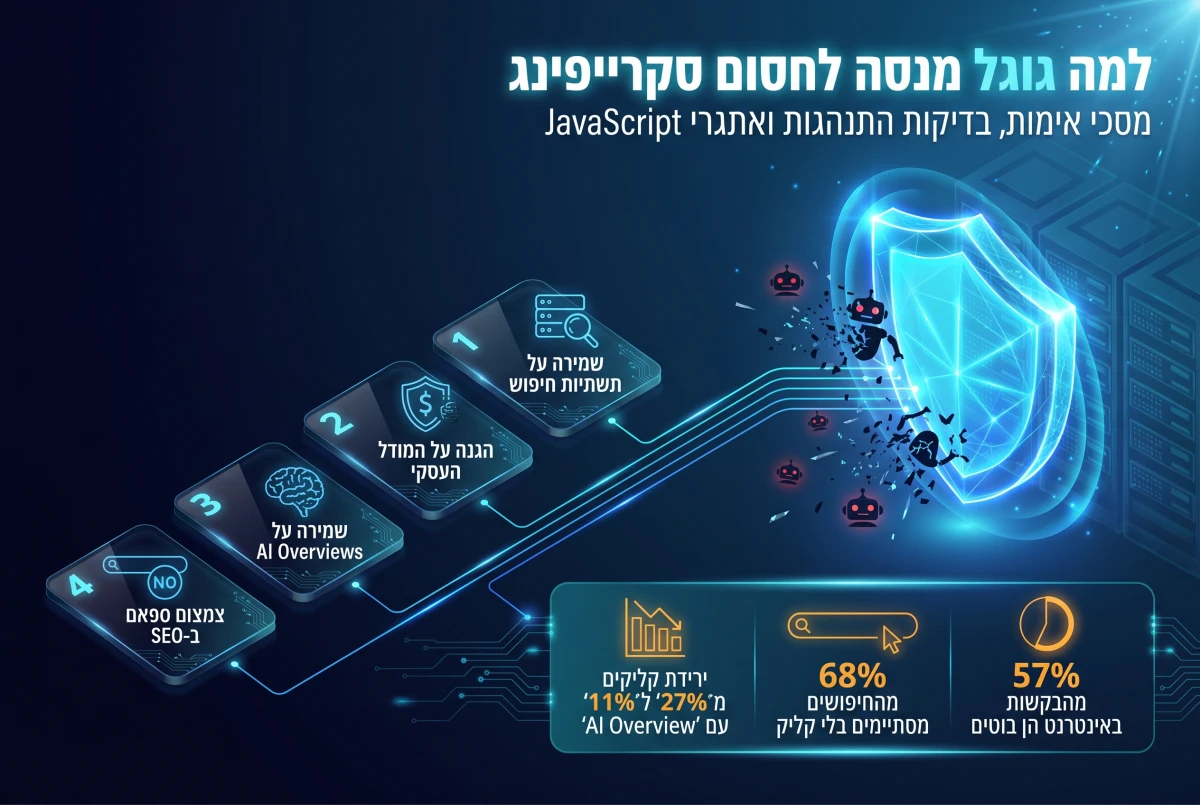
ההיבטים המשפטיים של סקרייפינג ברשת אינם זהים לפריצה למאגר סגור. כאן בדרך כלל מדובר באיסוף של מידע שמופיע לציבור על המסך. זה עדיין עלול להפר תנאי שימוש של הפלטפורמה, וזו בדיוק אחת הסיבות שגוגל משקיעה יותר בחסימות טכניות מאשר בהסברים. לפי Cloudflare, בוטים אוטומטיים מייצרים 57 אחוז מכלל הבקשות באינטרנט. הנתון הזה מסביר למה כל מנוע חיפוש גדול רואה בתעבורה אוטומטית קודם כול בעיית תשתית.
למה גוגל הכריזה מלחמה על הסקרייפרים דווקא בשנה האחרונה
ב-2026 האיסוף האוטומטי של תוצאות חיפוש הפך מעבודה טכנית שגרתית לעימות פעיל מול גוגל. מי שניסה לעקוף את החסימות פגש יותר מסכי אימות, יותר בדיקות התנהגות ויותר דרישות אתגר JavaScript מחמירות. זה לא קרה במקרה. מנוע החיפוש מגן עכשיו על כמה נכסים שונים בבת אחת.
מחסומי אימות ואתגרי הרצה: כיצד נחסמים הבוטים
החסימה כבר לא נשענת על כתובת IP או על CAPTCHA פשוט בלבד. גוגל בודקת אם הסביבה שניגשה אליה נראית כמו דפדפן אנושי, אם יש הרצה מלאה של JavaScript ואיך הבקשות נשלחות. בחלק מהמקרים היא בודקת גם אם המשתמש מצליח לעבור מסך אימות לפני שהתוצאות נטענות. לכן סקרייפר ישן שבנוי רק על בקשות רשת קלות קורס מהר יותר, גם אם פעם הוא עבד היטב.
מסכי אימות מסוימים משאירים את כפתור ההמשך אפור לכמה שניות, עד שהבקשה אומתה כאנושית. נצפו גם בדיקות שמחייבות התחברות לחשבון לפני גישה לתוצאות חיפוש. מבחינת גוגל, אלה צעדים ישירים נגד מערכות שמנסות לאסוף תוצאות בקנה מידה גדול בלי להיות משתמשים אמיתיים.
הגנה על תשתיות, מודלים מסחריים ותשובות מבוססות בינה מלאכותית
המלחמה של גוגל בסקרייפרים נובעת מארבעה לחצים שפועלים יחד:
- שמירה על תשתיות חיפוש מפני עומס של בוטים אוטומטיים.
- הגנה על המודל העסקי, משום שבוטים אוספים מידע מתוצאות החיפוש בלי לראות מודעות ובלי לייצר ערך מסחרי למערכת.
- שמירה על AI Overviews ועל רכיבי תשובה אחרים מפני קציר חופשי בידי מודלי שפה (LLMs) ומתחרים.
- צמצום של ספאם ב-SEO ושל ניסיונות למדוד או לנצל את גבולות האלגוריתם דרך שאילתות אוטומטיות.
הלחץ המסחרי חשוב במיוחד. לפי SparkToro, 68 אחוז מהחיפושים בארצות הברית מסתיימים בלי קליק החוצה לאתר חיצוני. כשיותר תשובות נשארות בתוך גוגל, כל פיקסל בדף התוצאות שווה יותר. לפי The Telegraph, כש-AI Overview מופיע בראש הדף, שיעור ההקלקה על התוצאה האורגנית הראשונה יורד מ-27 אחוז ל-11 אחוז. בתנאים כאלה קל להבין למה גוגל רוצה שליטה מלאה על המידע שמופיע על המסך שלה.
יש כאן גם שכבה טכנית חדשה. בעבר היה משתלם לסקרייפר לאסוף קישורים וכותרות. היום הוא רוצה גם תשובות שנוצרו בתוך הדף, סיכומים, תיבות מידע ורכיבים שמשתנים לפי הקשר. מבחינת גוגל, זה כבר לא רק איסוף של רשימת תוצאות. זה איסוף של מוצר שלם. לכן הניסיון לעקוף את החסימות נעשה קשה יותר, יקר יותר ופחות צפוי.
עד כמה אפשר לסמוך על נתוני דירוג ומתחרים היום
נתוני מיקום חיצוניים עדיין שימושיים, אבל אתם צריכים לקרוא אותם נכון. הם מציגים תמונת מצב משוערת שנלכדה בזמן, ממקום מסוים, דרך סביבת חיפוש מסוימת. הם לא משקפים במדויק את מה שכל אדם יראה ברגע החיפוש שלו, כי גוגל מתאימה תוצאות לפי מיקום מדויק, סוג מכשיר, היסטוריית חיפוש ולעיתים גם לפי השעה.
אשליית המיקום הראשון: מלכודת הבדיקה הידנית
הטעות הנפוצה מתחילה בבדיקה ידנית. אתם מקלידים את ביטויי המפתח שלכם בגוגל כדי לבדוק איפה אתם מופיעים, ורואים תוצאה שמחמיאה לכם. בפועל זו בדיקת מיקומים מותאמת אישית. אתם נכנסים לאתר שלכם שוב ושוב, מחפשים את המותג שלכם הרבה ועובדים תמיד מאותו אזור, ולכן אתם עשויים לראות את עצמכם ראשונים. לקוח חדש יכול לראות את אותו אתר רק בעמוד השני.
מעקב מיקומים ידני כמעט תמיד יוצר ביטחון שגוי. הוא מערבב בין נראות אישית לבין נראות שיווקית. אם אתם רוצים להבין מה קורה באמת, אל תשאלו רק איפה אתם מופיעים אצלכם במסך. בדקו גם חשיפות, קליקים, דפים שמקבלים הופעות חדשות, ומגמות לאורך זמן בתוך Google Search Console.
גם בין כלי SEO שונים תקבלו לפעמים תשובות שונות לאותה שאילתה באותו יום. כלי אחד סרק מאזור אחר. אצל כלי שני זיכרון המטמון היה ישן יותר. כלי שלישי מדד במובייל ולא בדסקטופ. לכן הפער בין מערכות לא אומר בהכרח שאחת משקרת. לעיתים הן פשוט הסתכלו על אותו SERP מזוויות שונות ובזמנים שונים.
ממעקב מיקומים אובססיבי להחלטות תוכן מבוססות נתונים
גם אנחנו לא מתייחסים למספר מיקום כאל אמת מוחלטת. מעקב מיקומים חשוב פחות ממעקב ביצועים מאומתים וכיסוי תוכני נכון. אם עמוד מקבל יותר חשיפות, אם יותר שאילתות מתחילות להופיע, ואם יש פער ברור בין מה שהאתר שלכם מכסה לבין מה שהשוק מחפש, יש לכם משימה ברורה. תנודה יומית של מקום אחד למעלה או למטה לרוב לא נותנת החלטה טובה בפני עצמה.
הצעד הנכון לרוב האתרים בעברית הוא לעבור ממסך דירוגים למסך עבודה. חפשו ב-Google Search Console אילו עמודים מקבלים חשיפות בלי מספיק קליקים, אילו נושאים עולים אבל עדיין מקבלים כיסוי חלקי, ואיפה המתחרים בנו שכבה תוכנית רחבה יותר משלכם. אם אתם רוצים לעבוד מסודר על זה, לקסה יכולה לעזור לכם לסרוק את האתר, לבדוק מתחרים ולבנות סדר עדיפויות מעשי, בלי להישען רק על נתוני דירוג שנאספים מבחוץ.